深度甲基熊江辉:长寿医学智能(长寿智能)的三座大山与四大路径
当 AI 成为基础设施,长寿医学的瓶颈不再是算力,而是三座大山:读懂一个人的状态、画一张可检验的地图、在多病共存中做选择。本文是与深度甲基首席科学家熊江辉博士的对话整理:四条翻山路径——选择智能、向 FDA 学 N-of-1 证据逻辑、让任何知识体系都能接入的地图接口、让地图考试让经验入账——以及它们汇合的地方:虚拟长寿诊所(VLC)。
阿康 × 深度甲基首席科学家熊江辉博士|对话整理
所谓“后 AI 时代”,不是 AI 退场,而是 AI 像水电一样成为基础设施之后:通用智能越来越充裕,也越来越便宜。当智能不再稀缺,生命科学的瓶颈就不再是“算得够不够快”,而是敢不敢跳出原来的框架去想问题。这是一段属于 AI 生命科学的奇妙旅程,而长寿医学正站在它的入口。
10 月 6 日,深度甲基发布论文《虚拟长寿诊所:面向生物医学世界模型的版本化状态图框架与软件测试台》(The Virtual Longevity Clinic: A Versioned State-Map Framework and Software Testbed for Biomedical World Models,简称 VLC,预印本)。借这个机会,阿康和熊博士聊了一下午,从这篇论文和此前发布的几篇论文说起。熊博士横跨生物学、特种医学和计算机三个学科,更像一位长寿医学的“架构师”:借助 AI,先搭起一套能接入、能检验、能迭代的工程体系,再在体系里逐个研究模块。本期关键问题:
- 长寿智能的三座大山是什么?
- 为什么说“预测是手段,选择是目的”?最近引发关注的 Jev 为什么只做选择题?
- FDA 为一个人的药开路,长寿医学能学到什么?
- 衰老生物学、功能医学、传统医学,能不能接入同一张地图?
- 马斯克说,未来的发现“四舍五入就是 100% 的工程”。长寿医学是科学问题,还是工程问题?
- 深度甲基的路线图走到了哪一站?想亲手试一试,去哪里看?
从能力出发
阿康:熊博士,VLC 论文刚刚发布,我们待会儿细聊。先说说您自己。您的背景挺特别:生物学学士、特种医学硕士、计算机博士,此前还研究了 21 年航天医学。一路跨了好几个学科,是怎么走过来的?
熊博士:生物学让我理解生命,特种医学让我理解人体在不同环境下的适应,计算机让我能把这些问题变成可计算的模型。跨的学科多了,我习惯先看整体结构,再看局部细节。一路下来我越来越觉得,与其描述一个人“有什么病”,不如评估他“还有多少能力”。这个想法后来发展成能力组学(Capomics),它的出发点是一条第一性原理,也就是不依赖其他假设的最底层判断:生命是适应环境的能力集合体。
阿康:为什么说现在是“后 AI 时代”?
熊博士:因为 AI 正在从稀缺能力变成随处可得的基础设施,推理和分析的成本还在持续下降。过去我们受限于算力和分析能力,很多想法只能停在纸面上;现在瓶颈转移了:读一个人的什么状态,用哪张地图,做什么选择,什么才算证据。这些问题没法靠堆算力解决,但智能充裕给了我们跳出原有框架思考(think out of the box)的底气。
阿康:说回这次发布的 VLC 论文。“虚拟长寿诊所”这个名字很抓人,它在这条路上处于什么位置?
熊博士:它是一个汇合点。VLC 是一个 AI 智能体的研究原型,服务的是长寿医学里的 N-of-1 场景。N-of-1 就是“样本量为 1”:只看一个人,拿他自己前后的变化做对照。它现在是研究原型和软件测试台,还不是临床决策系统[1]。
阿康:DeepKang(深度康能)网站上有一张“乐园导览图”,这条路该怎么看?
熊博士:可以当成一次游园。DeepKang 的导览图把 7 篇已发布论文和 17 个工程模块放在了同一条路线上。下面这张是按今天聊的内容简化重画的:从一次测量出发,路上横着三座大山,四条路径各自找山口翻过去,最后在 VLC 汇合。
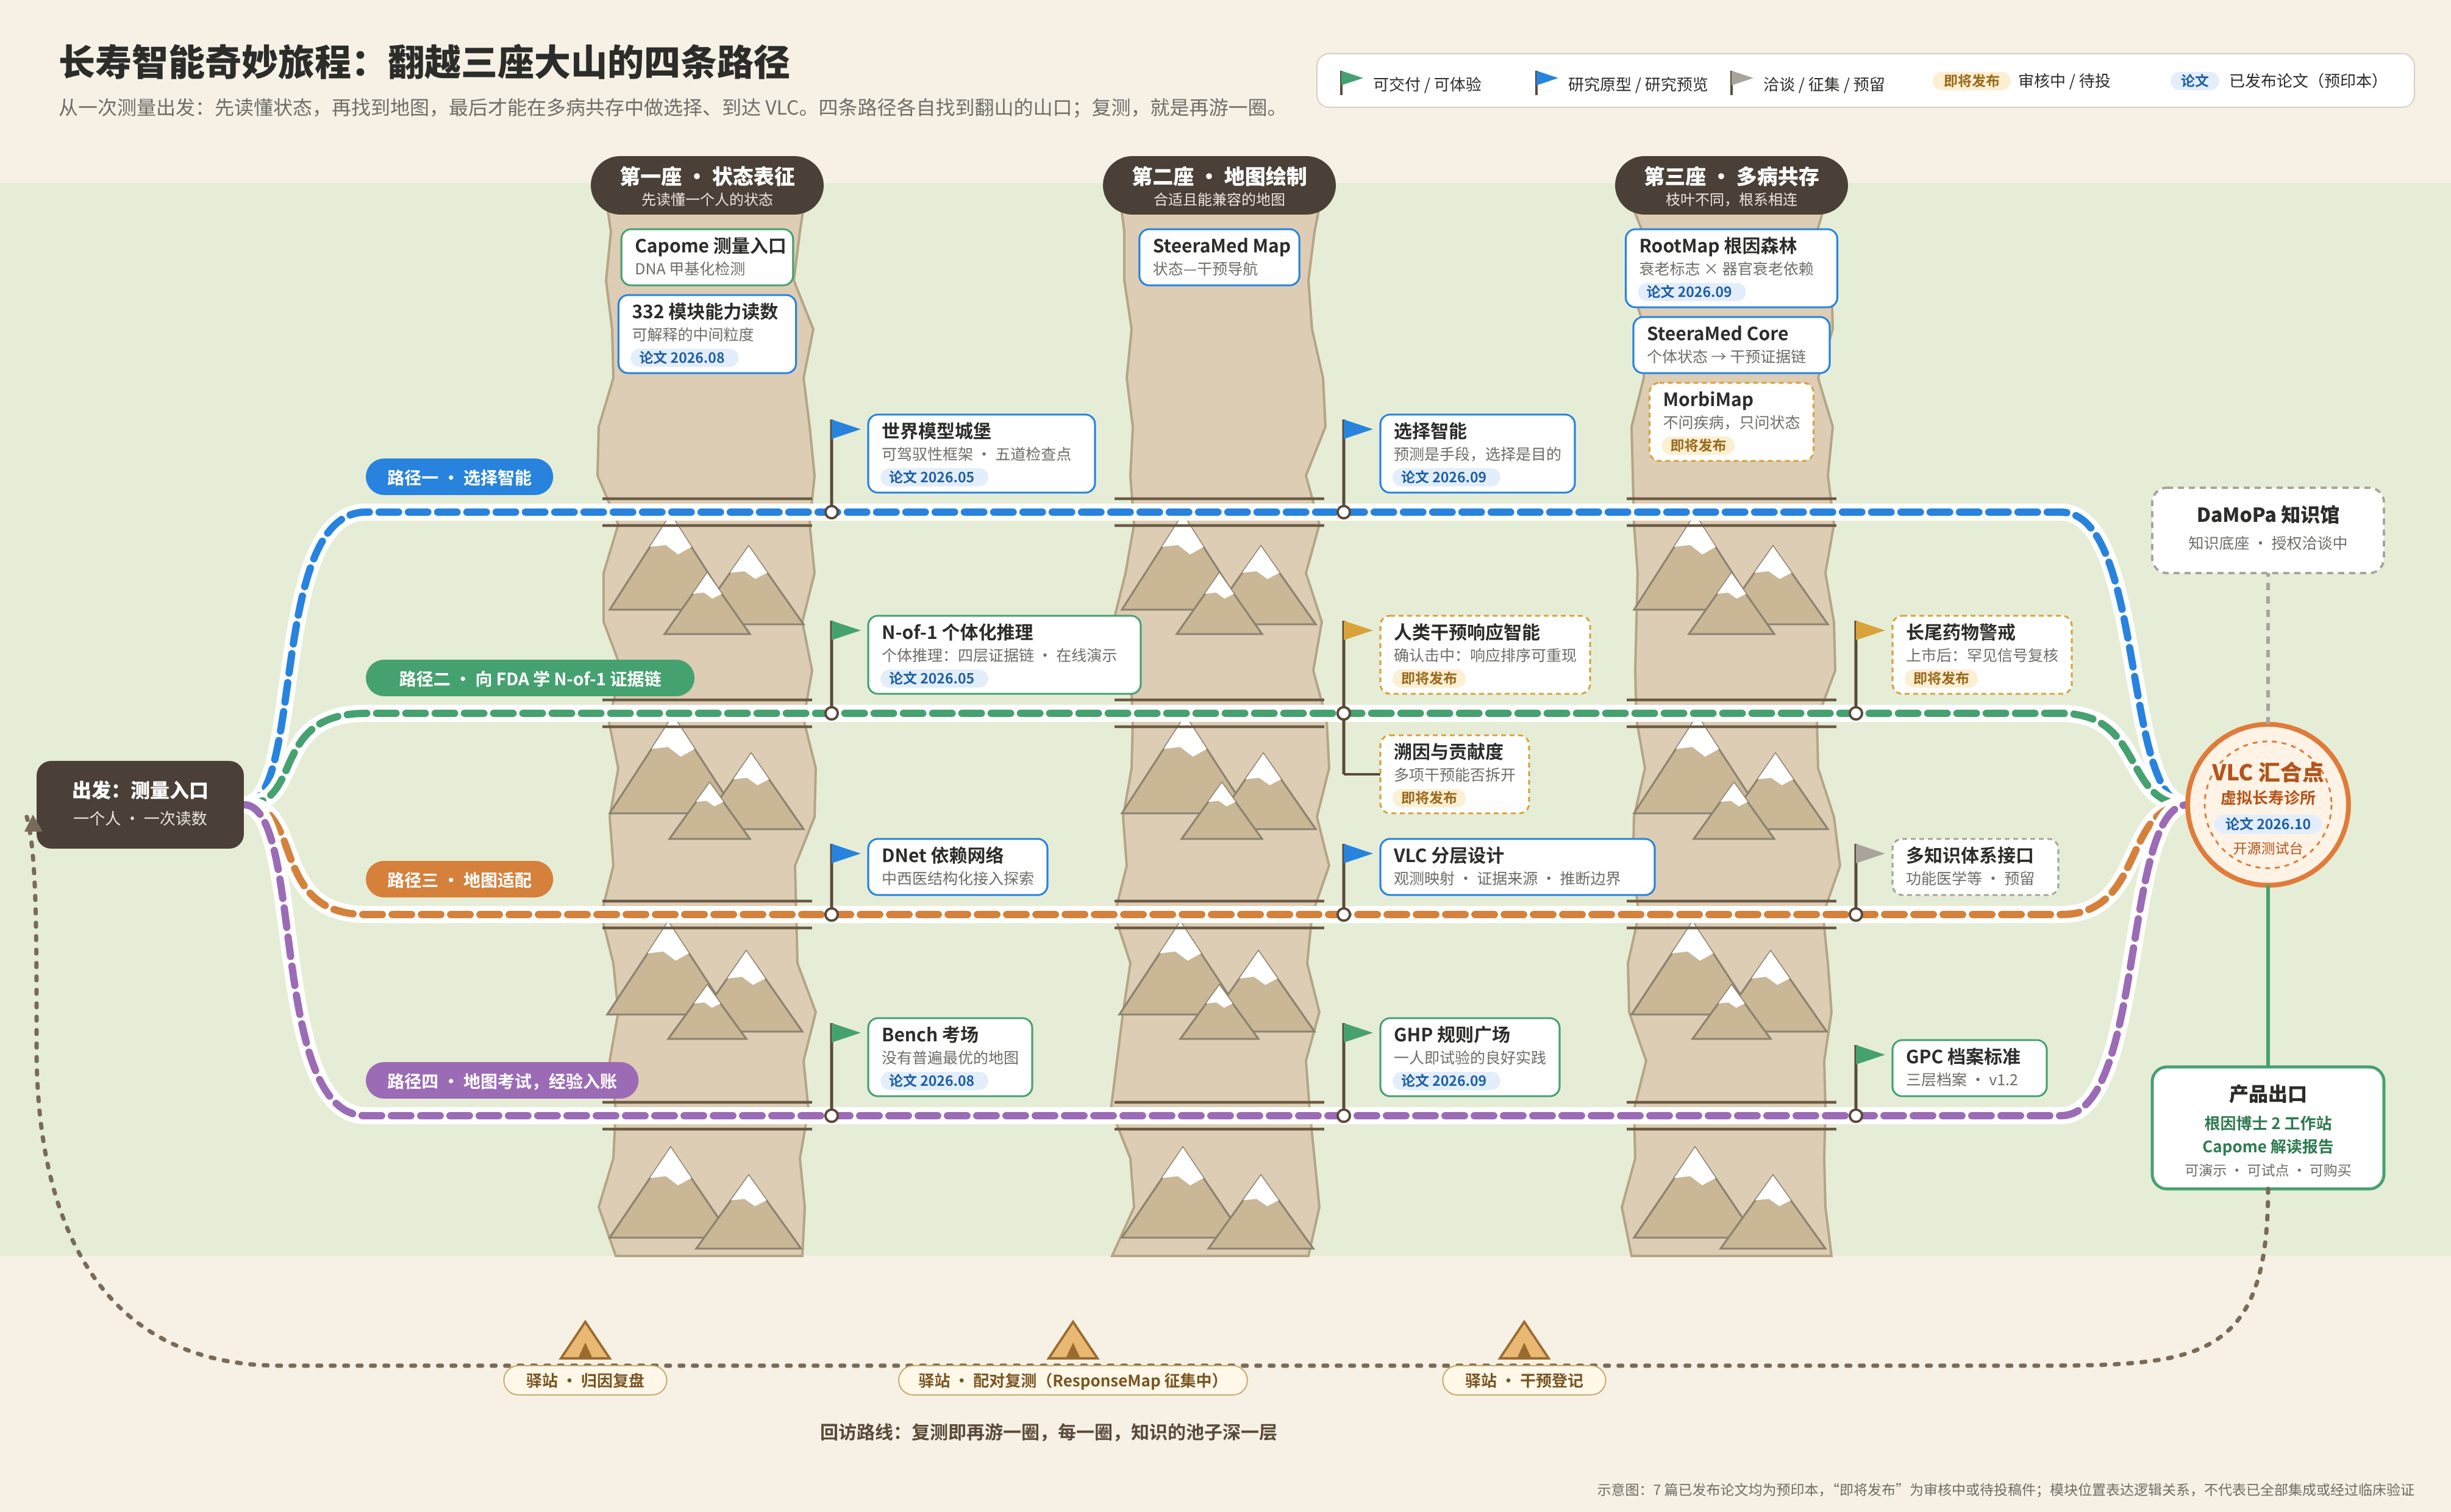
熊博士:旗子的颜色代表成熟度:绿色已经能用,蓝色还在研究,灰色在洽谈或预留;蓝色“论文”标签是已发布的论文,都是预印本;橙色“即将发布”是正在审核或准备投稿的论文。每复测一次,就是再游一圈。
先看看路:行业在走的几条路
阿康:“世界模型”现在很热。生物医学领域都有哪些路线?
熊博士:大致四条。一是虚拟细胞:用基因表达等多种分子测量数据(多模态组学)训练细胞层面的模拟器,预测细胞在药物、基因编辑等“扰动”下会如何变化[2]01332-1);Arc Institute 的虚拟细胞挑战赛首届就有 5,000 多人注册、1,200 多支队伍提交。二是医学数字孪生:为每个人建一个虚拟的“数字分身”,模拟其生理与疾病过程,难点在数据获取和验证[3]。三是知识图谱和生物基础模型:前者把基因、疾病、药物之间的已知关系连成一张大网,后者用海量生物数据预训练通用模型,规模都很大,但证据强度参差不齐。四是大模型智能体:擅长对话和推理,但通常不会明确记录一个人的状态,也说不清结论的证据边界在哪里。
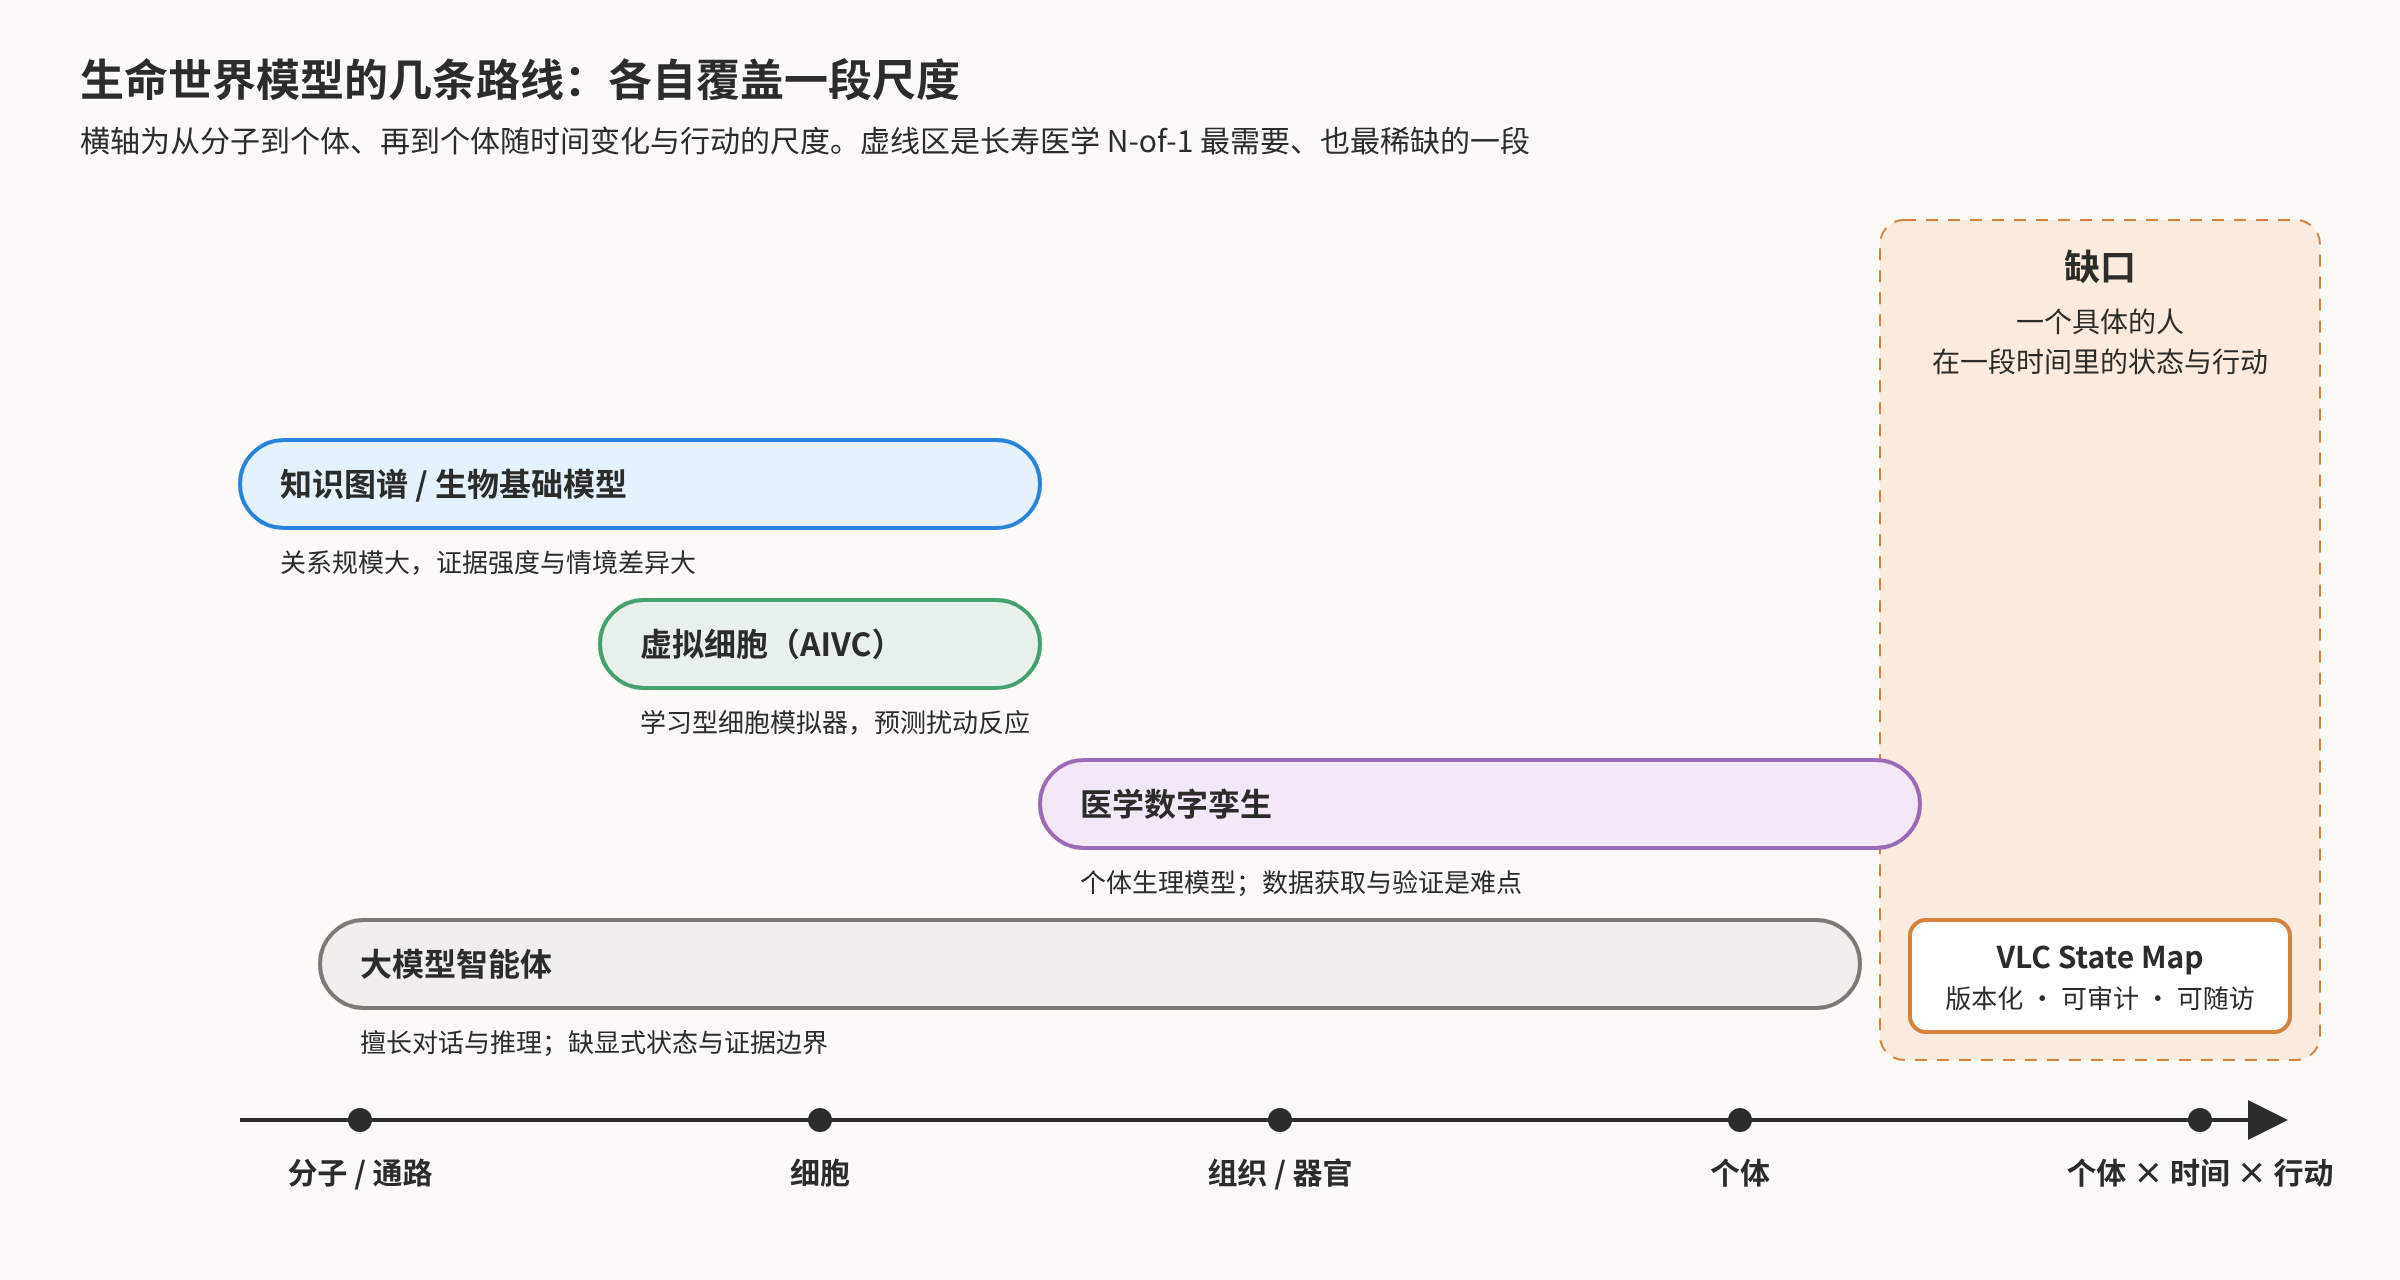
熊博士:这些路线互相补充,但都在同一处留了空白:一个具体的人,在一段时间里的状态与行动。长寿医学要的恰恰是这一段。
三座大山
阿康:要走到那一段,必须翻越哪几座山?
熊博士:三座:状态表征、地图绘制、多病共存。顺序很重要。多病共存是很多人出发的理由,却是最后一座山:要先读懂一个人的状态,再找到合适的地图,才能在多病共存中做选择。
第一座:状态表征
阿康:先说第一座。一个人的“状态”该怎么读?现在各种衰老时钟已经很多了。
熊博士:检测比决策跑得快:能测的东西越来越多,但“测完该怎么办”没有跟上。衰老时钟给出的一个生物年龄数字,撑不起“先做什么、后做什么”;把所有指标都堆进来,又失去可解释性。我们需要一种中间粒度:比单个数字细,比成千上万个指标粗;既有生物学含义,又能从个人的检测数据中读出来。我们现在用的是 332 个命名基因模块,读数来自 Capome 的 DNA 甲基化检测(DNA 甲基化是附着在 DNA 上的一类化学标记,不改变基因序列,却会随年龄、环境和生活方式变化,因此可以当作身体状态的“读数”),每个模块是一组功能相关的基因,给出一个可解释的能力读数,分属衰老标志、器官系统、代谢、免疫、营养响应等 11 个家族[4]。
第二座:地图绘制
阿康:有了状态读数,什么样的地图才算“合适的地图”?
熊博士:地图不是越大越好。网络医学常用的蛋白互作图,记录的是哪些蛋白质之间有物理相互作用,比如彼此结合,却不直接告诉你这对健康意味着什么[4]。合适的地图要对任务有用,能在公开的标准测试(基准)上被检验,每次修改可回溯,每条关系标明来源、证据强度和不适用之处。
熊博士:更难的是兼容。衰老标志、器官系统、功能医学、营养与运动科学,乃至传统医学,各有概念和经验。就连下一座山“多病共存”,定义都不统一,老年人群患病率估计从 4.8% 到 93.1% 不等[5]。强行统一会丢掉大量知识,各说各话又无法比较和积累。
第三座:多病共存
阿康:最后一座,多病共存,难在哪里?
熊博士:全球成人多病共存患病率约 37.2%,60 岁以上人群中超过一半同时患有两种及以上慢性病[6]00037-8/fulltext)。而医疗体系按单病组织:一个科室、一份指南、一组指标,叠加到同一个人身上,就是检查重复、用药叠加、目标冲突。长寿医学客户往往同时进行五到十项干预,一年后很难说清哪一项起了作用[4]。怎么把账算清,后面路径二会讲。
熊博士:衰老生物学提供了另一种视角:2023 年更新的“衰老标志”框架列出 12 类相互关联的机制[7]。枝叶不同,根系相连。问题就从“这个人有哪些病”,变成“这个人的系统处于什么状态,哪里最值得先干预”。这一步,正好要用上前两座山的成果:先有状态读数,再有能看清根系的地图。
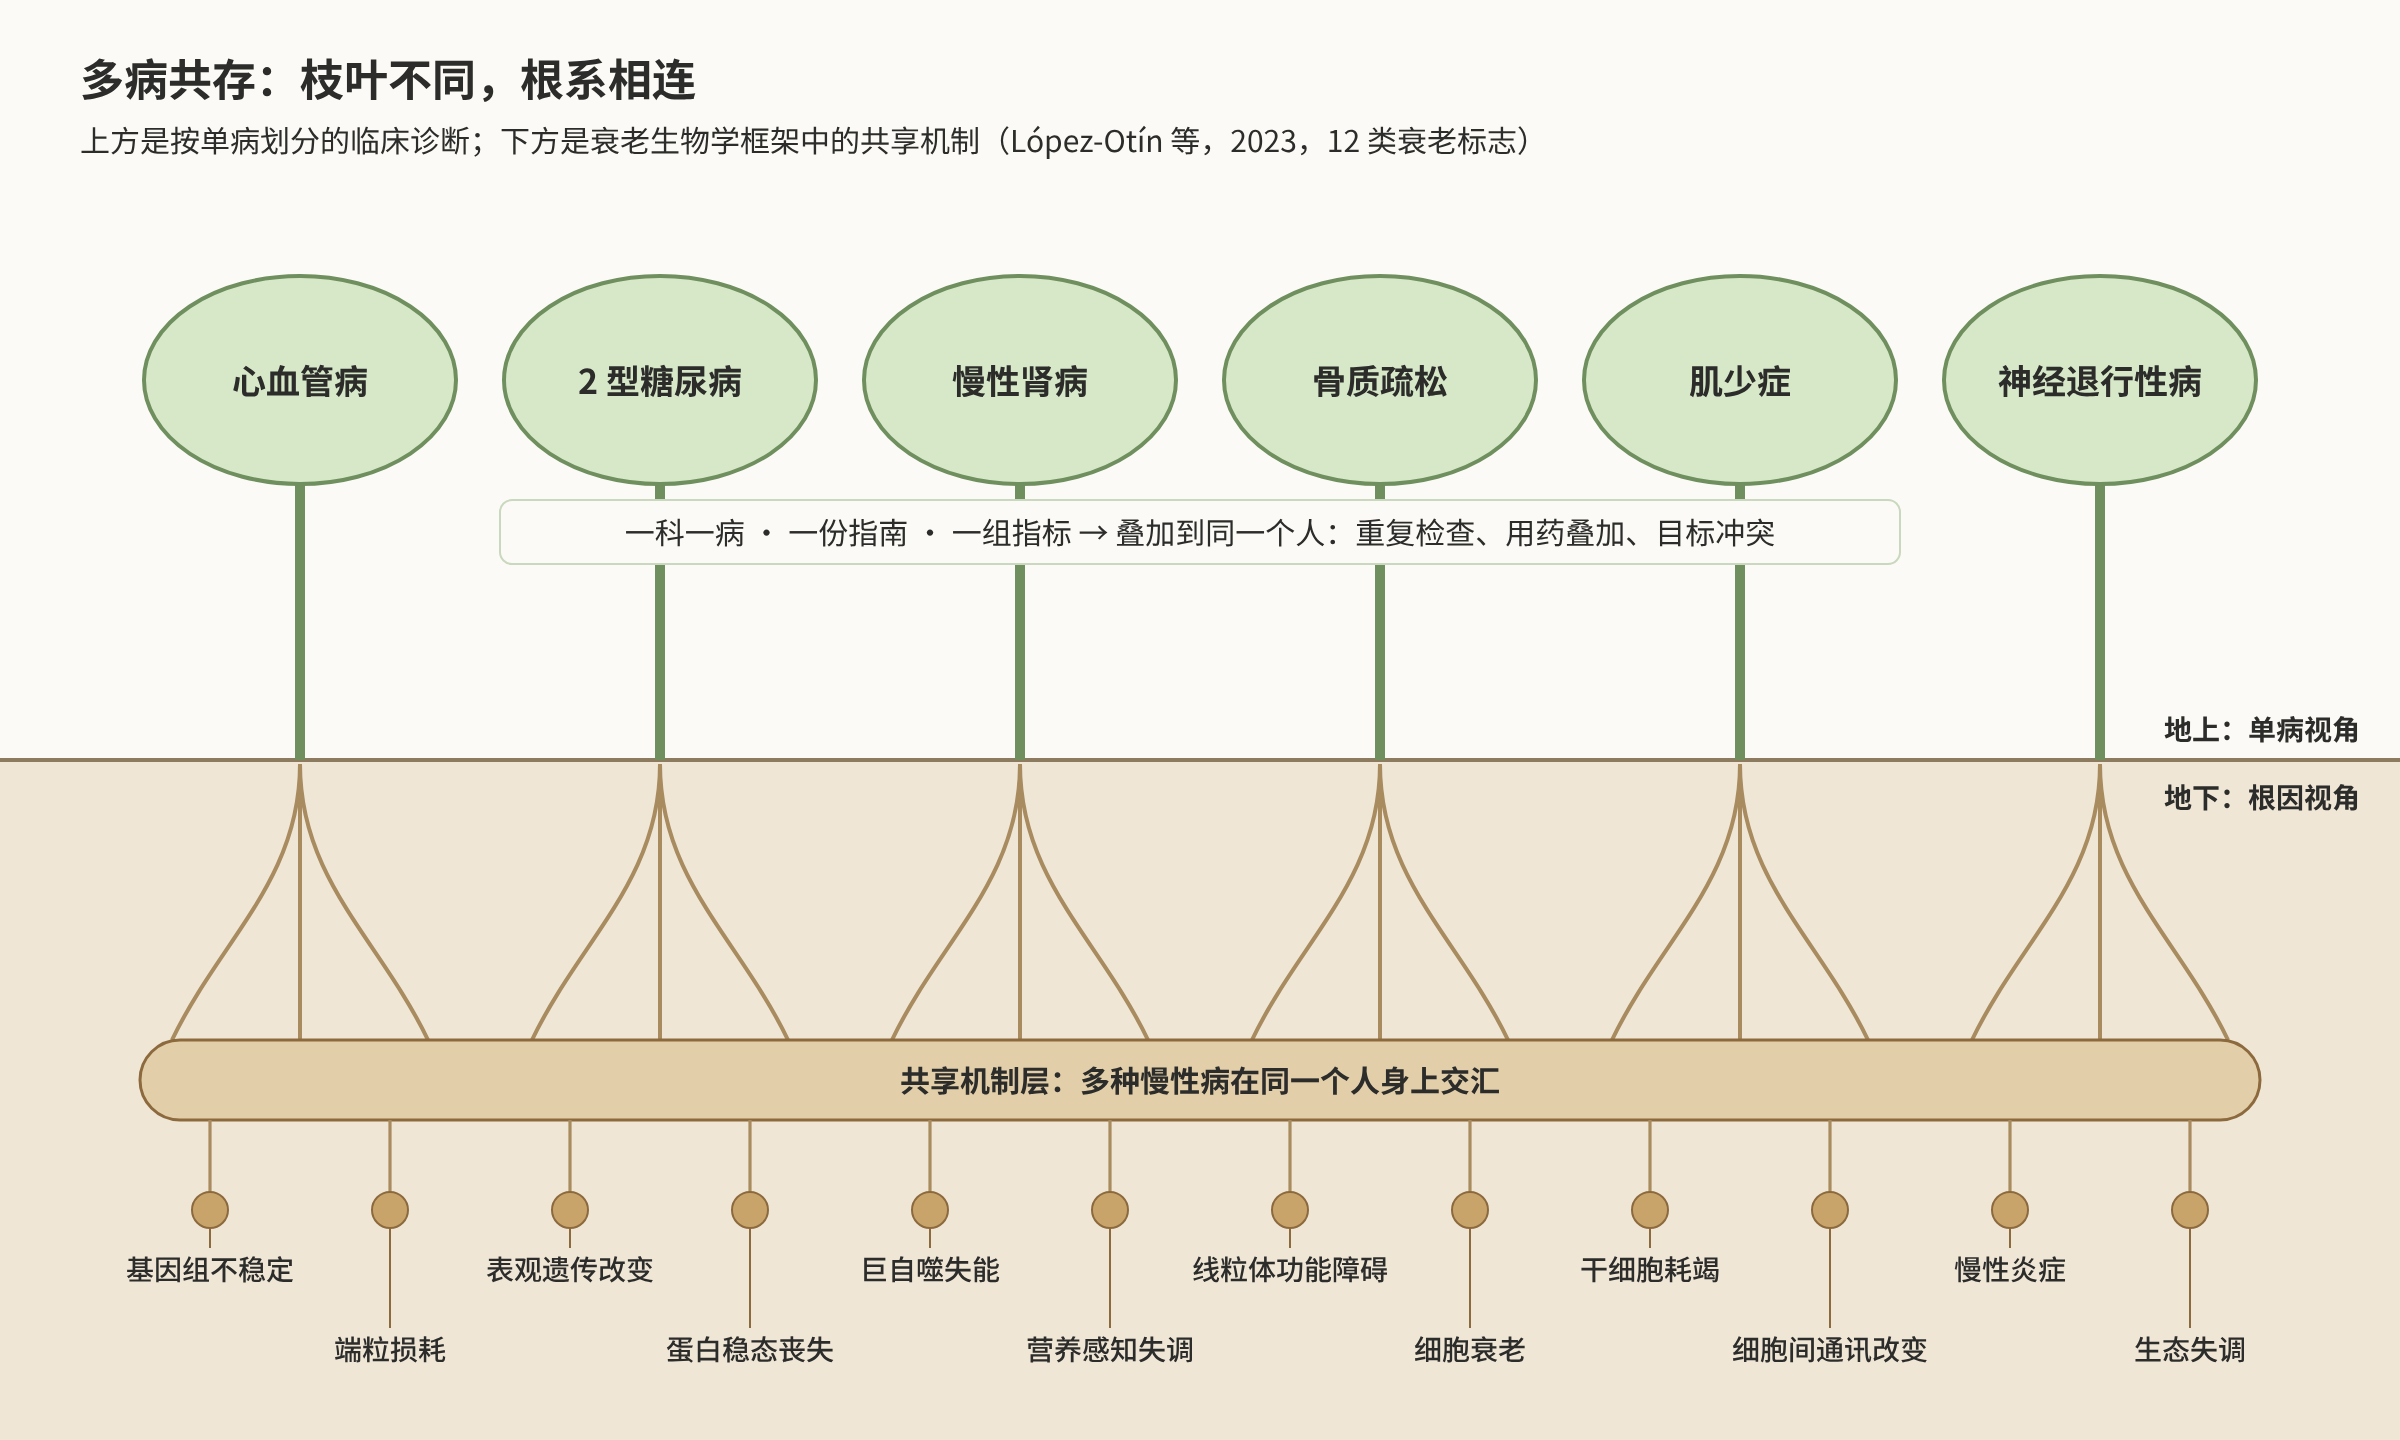
熊博士:我们即将发布的 MorbiMap 论文就在试这条路:不先给人贴疾病标签,直接从一个人的模块状态出发,给候选药物排序。初步结果有正面信号:在高血压数据里,前 20 名中有 6 个降压药,而随机排序平均只有约 2.4 个[8]。但这项研究还没有检验治疗响应,所以排出来的只是研究候选,疗效还没有经过检验。
四大路径
阿康:山找到了,路怎么走?
熊博士:我想到四条路径,都不是从“更大的模型、更多的数据”出发的。三座山是要翻越的障碍,四条路径是翻山的办法,也回应了前面说的几个瓶颈:选择智能回答“做什么选择”;向 FDA 学 N-of-1,回答“什么才算证据”;地图适配和让地图考试,一起回答“用哪张地图”:前者让不同知识体系的地图都能接进同一份个人记录,后者检验哪张好用,并让经验一点点积累起来。至于“读一个人的什么状态”,就是第一座山要解决的。
路径一:选择智能——预测是手段,选择是目的
阿康:您 9 月底发布的一篇论文,标题就像一句口号:《预测是手段,选择是目的》(Prediction Is the Means, Selection Is the End)。为什么这么说?
熊博士:要说清这句话,得先讲我们围绕“可驾驭世界模型”写的两篇预印本。所谓“可驾驭”,是指模型不只要预测会发生什么,还要能指导往哪个方向干预、干预到哪里为止。第一篇是《World Models for Biomedicine: A Steerability Framework》,给生物医学世界模型设了五道约束检查点:先讲清描述哪种状态、怎样量化、干预后预期怎么变、状态如何随时间演变,最后整体再过一关。这样预测失败时,就能定位是哪一关出了问题,失败也成了可诊断的信号[9]。
熊博士:第二篇《Prediction Is the Means, Selection Is the End》更进一步:做干预决策,要的不是更准的“下一状态预测”,而是更好的选择,即对这个人、此刻、该做哪件事。所以要先研究可预测性,再做预测,也就是先问“这件事到底能不能被可靠预测”:先弄清在哪种表征、哪些条件下,干预响应能被可靠读出;负结果本身就标出了不该出手的区域。交付物也不是更大的预测器,而是一套“驾驭框架”,由约束、干预语义、目标和边界四部分组成[4]。
阿康:“选择 vs 预测”,让我想到最近引发关注的 Jev。
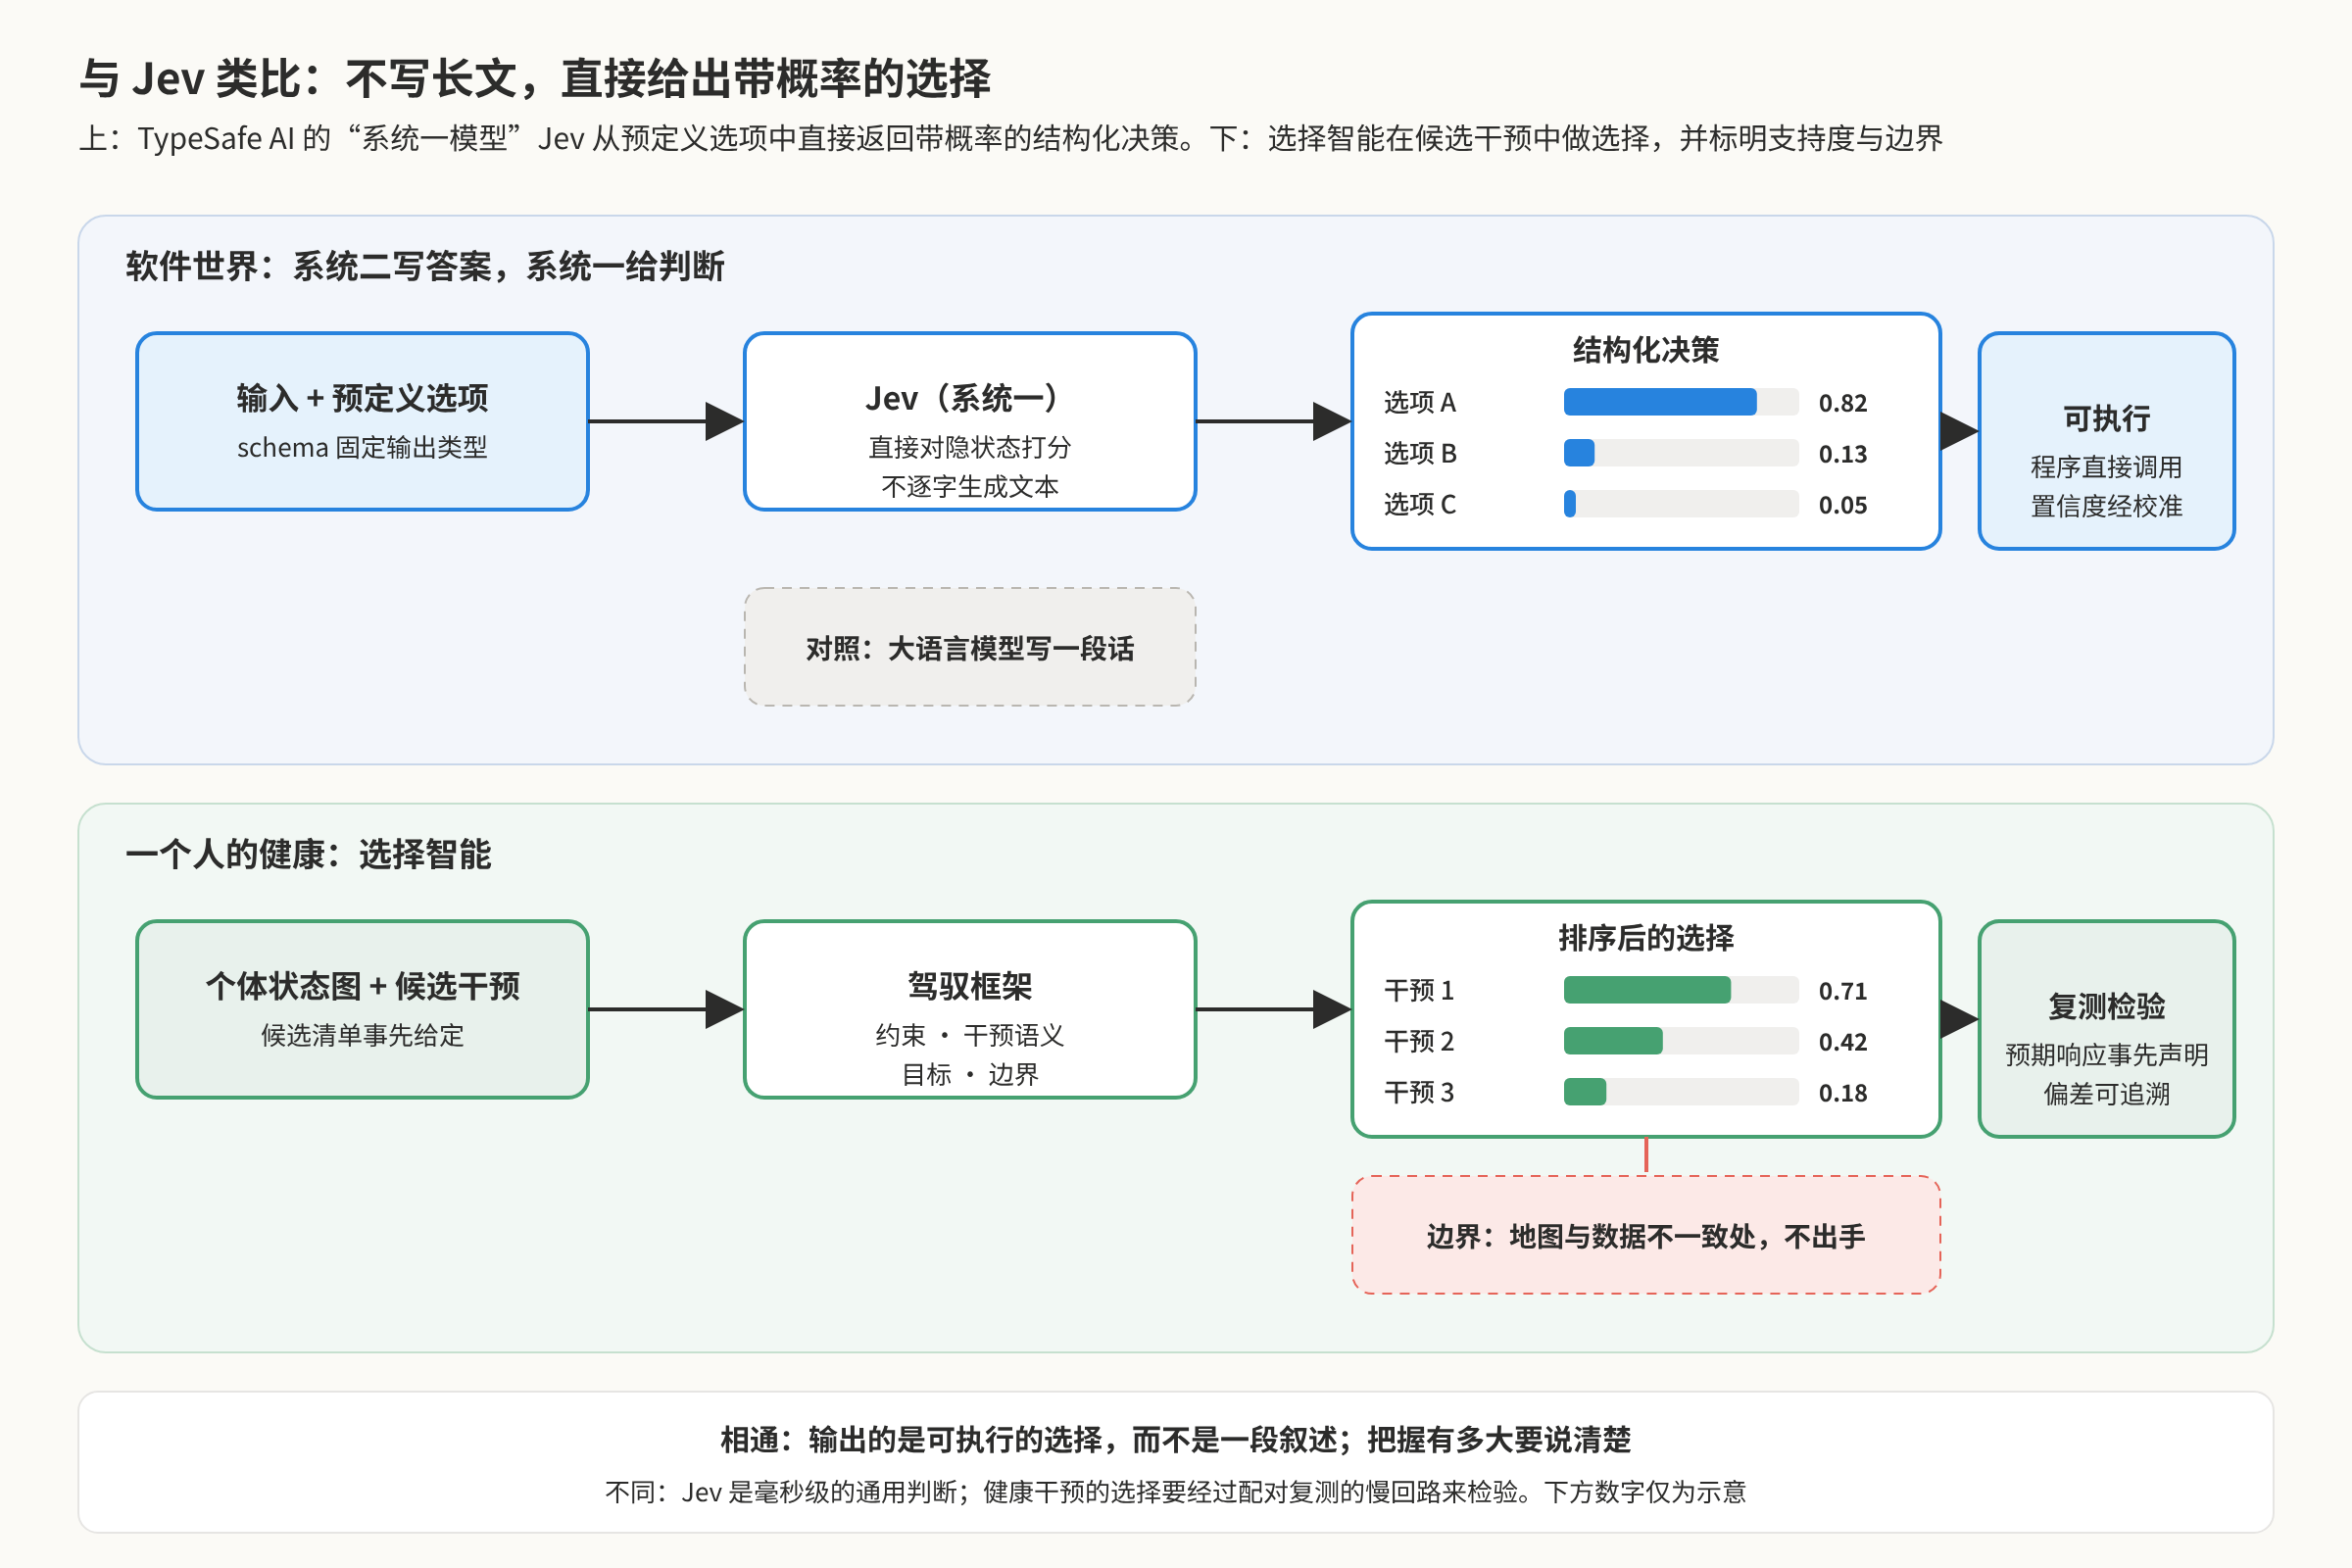
熊博士:正好可以放在一起说。Jev 是 TypeSafe AI 在 2026 年 9 月推出的“系统一模型”(“系统一”指快速的直觉判断),它只做一件事:做选择题。它不预测下一个词,也不和人对话,而是从预定义的选项里直接选出答案,并给每个选项附上经过校准的概率。所谓“校准”,是指在所有标注 0.9 把握的判断里,大约九成确实是对的。
熊博士:这和我们的世界模型思路是一致的。主流做法是让模型预测下一个状态,或者生成一段建议;我们认为,干预决策的本质也是一道选择题:给定一个人的状态图和一份候选干预清单,选哪一项、把握多大、哪些情况不该出手。预测只是帮助做选择的手段。VLC 也是这样设计的:它给出的建议,要能对应回事先给定的候选选项。目前做到了一部分:回放测试中,32 条建议有 29 条能对应回给定选项[1]。
阿康:区别在哪里?
熊博士:Jev 是快速的通用判断,健康干预的选择则要经过慢回路来检验:干预前后各测一次,两相对照(配对复测)。同一个人长期、多次的干预记录(纵向数据)在生物医学里很稀缺,所以我们先把已有的生物学知识写成明确的结构,再用配对观测去校准、修正或否定它。结构不替代纵向证据,它缩小的是稀缺数据要去检验的假设范围[4]。
熊博士:我常用牧羊人打比方:聪明的牧羊人不会先画完整片草原再赶羊。他先弄清哪里有水草,哪里有狼和荒漠,然后规划一条安全的路。放到长寿医学里,水草就是证据可靠、值得出手的区域;狼和荒漠就是预测不可靠、不该出手的地方。
路径二:向 FDA 学 N-of-1
阿康:N-of-1 在监管层面有先例吗?
熊博士:有,而且很有启发。2019 年,波士顿儿童医院团队为一名 CLN7 巴滕病(一种致命的罕见神经退行性遗传病)患儿定制了反义寡核苷酸药物 milasen。这类药物是一小段人工合成的核酸,能针对性地纠正致病基因的表达问题。从确诊到首次给药,只用了约一年[10]。2021 年,FDA 发布指南草案,讨论只针对一名或少数几名患者的个体化反义药物,如何提交临床研究申请。2025 年 11 月,FDA 领导层又在《新英格兰医学杂志》提出“合理机制路径”:明确的分子或细胞异常、干预作用于该异常本身或紧邻的上游通路、未治疗人群的自然史(不治疗时疾病会如何发展)、药物作用目标(靶点)被成功击中的证据、与疾病生物学一致的持续改善,以及上市后持续收集真实世界证据[11]。
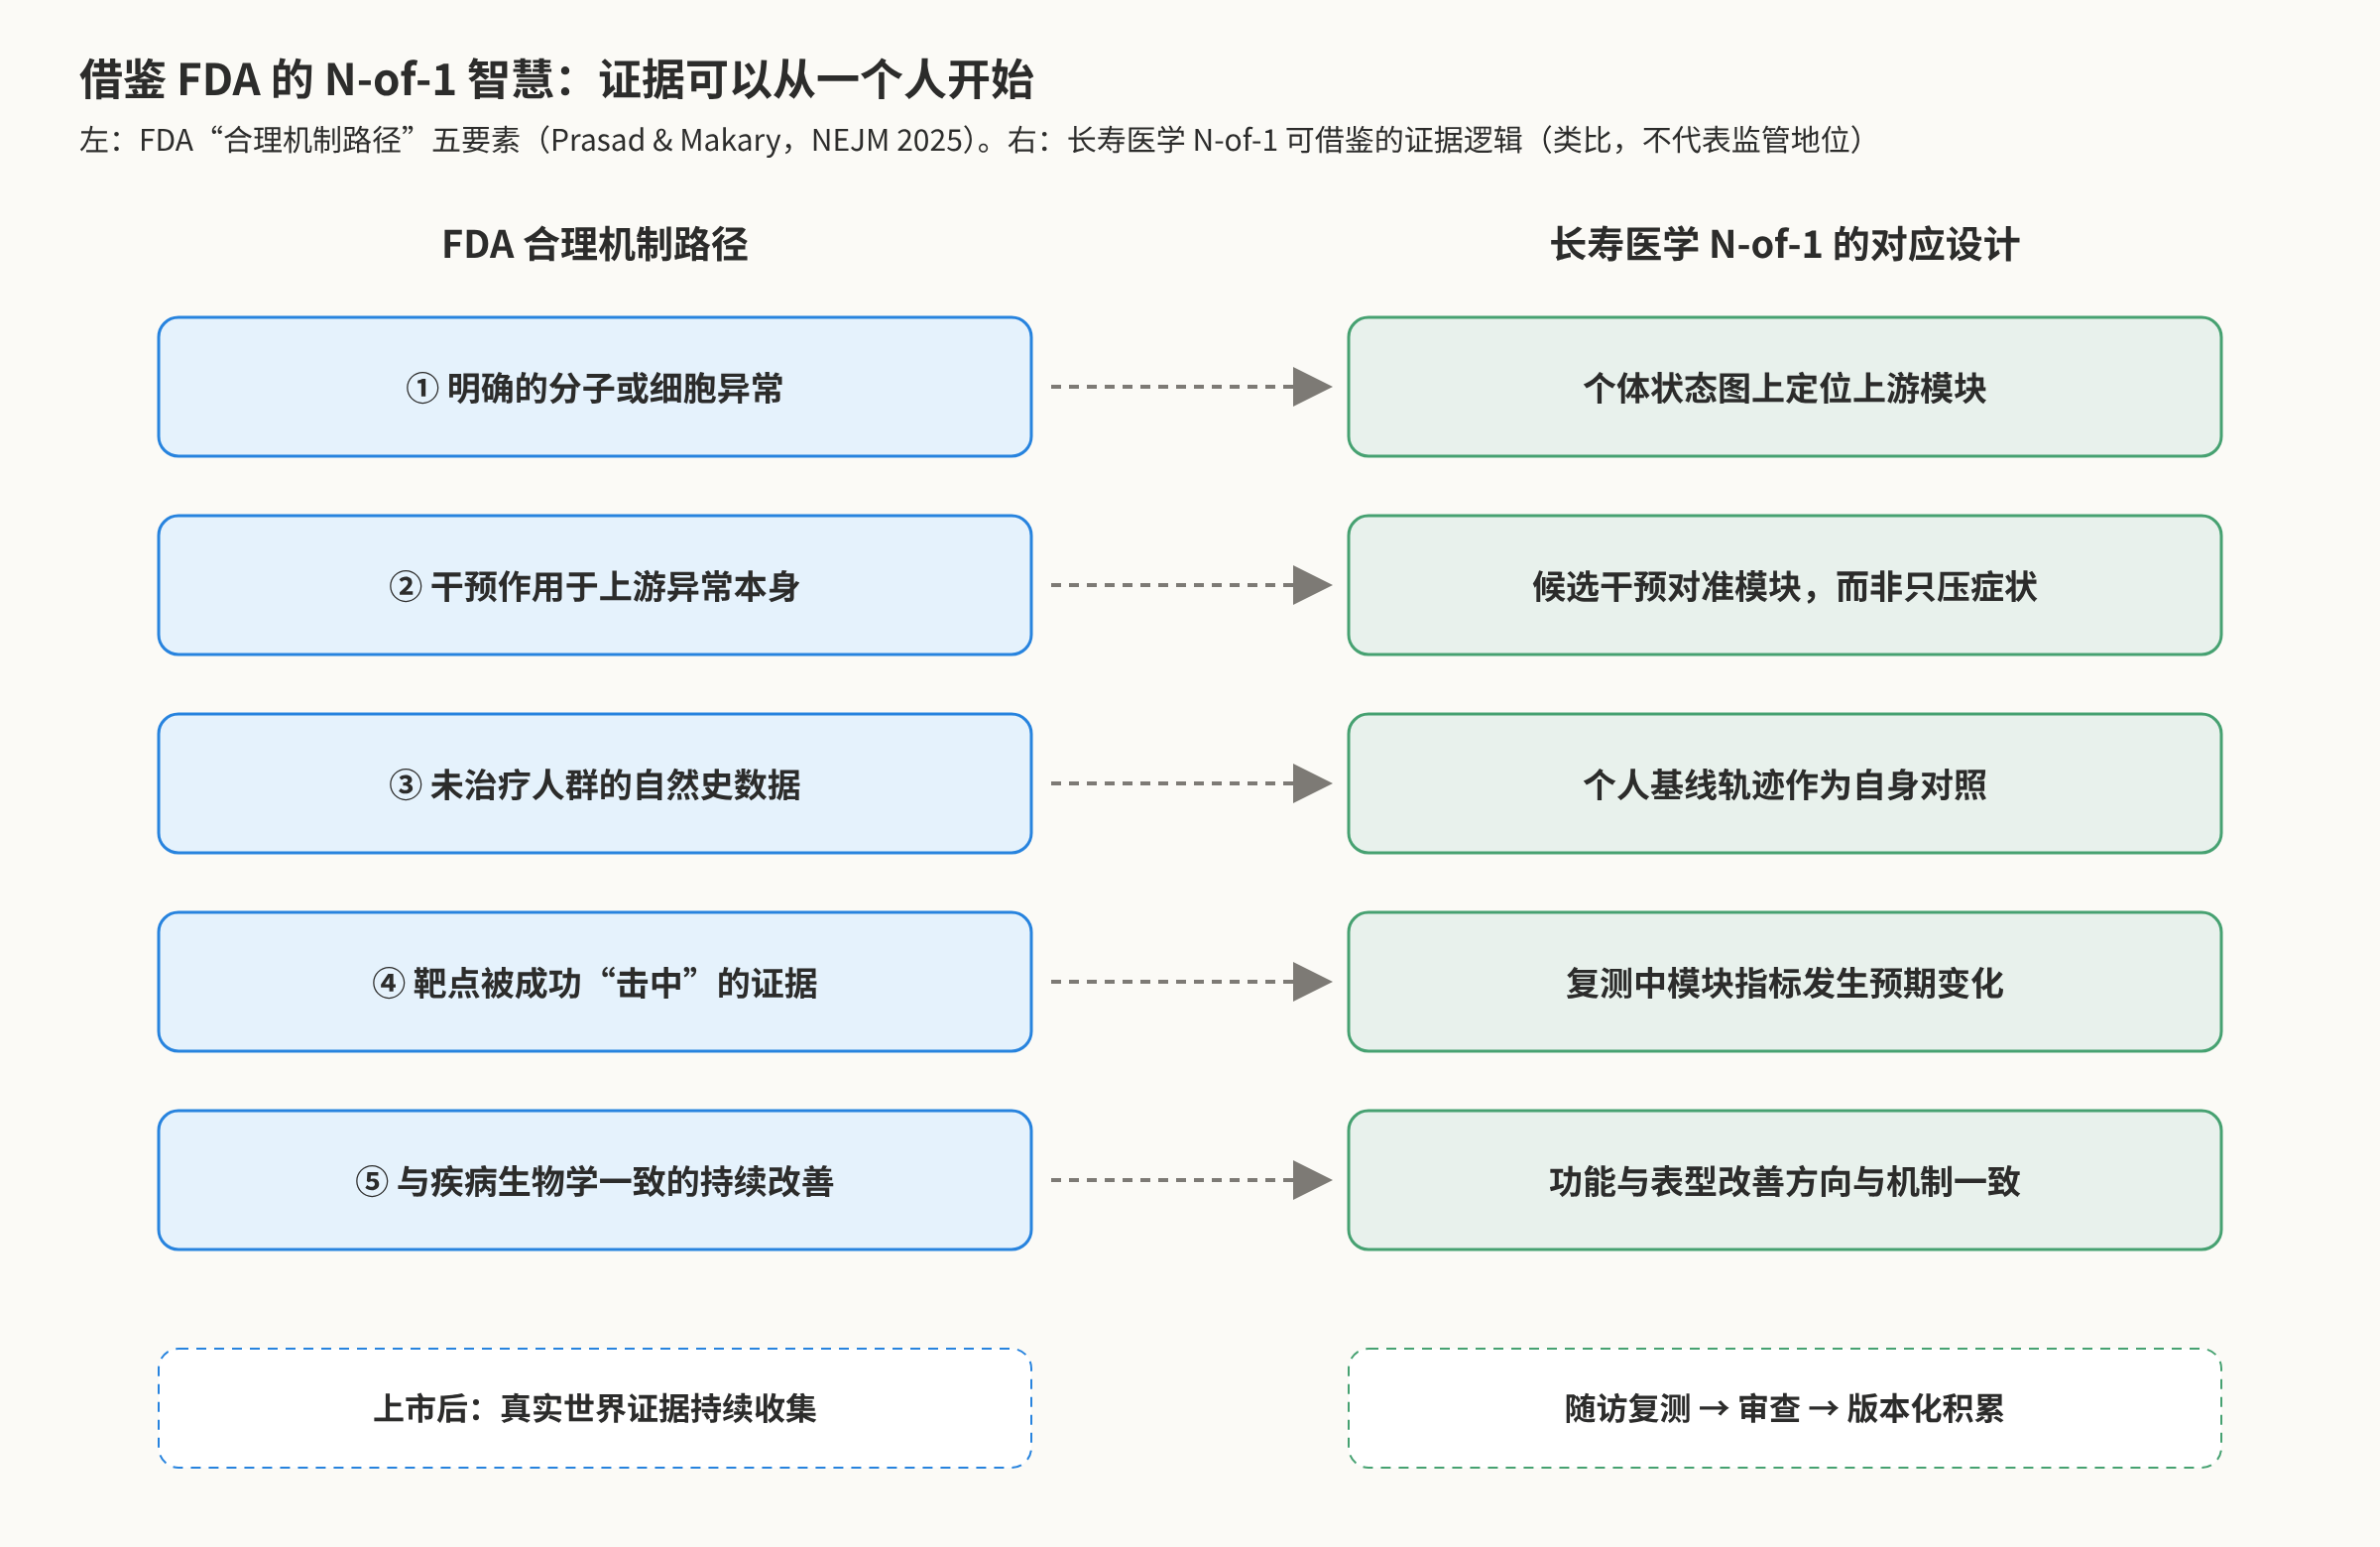
熊博士:这条路径面向病因明确的罕见病,不能直接套到长寿医学。但它的证据逻辑值得学:机制先行、对准病因上游、以自然史为对照、确认“击中”、看改善是否与机制一致、上市后持续追踪。放到长寿医学,个人基线轨迹可以充当自身对照,复测中模块读数朝预期方向变化,可以作为“击中”的初步证据,但还需要功能和表型的改善来印证。
阿康:这条证据链上,深度甲基自己在做什么?
熊博士:有一组论文在接力,每篇对应一环。第一环是“个体推理”:已经发布的 SteeraMed 论文,从一个人的分子状态出发,沿四层证据链推理候选干预,已在四种疾病上做了回顾性验证[12]。后面几环的论文还没发布,先预告一下。
熊博士:第二环是“确认击中”:即将发布的人类干预响应智能(VPR)论文,分析了 8 个干预队列、248 对干预前后的血液甲基化数据。结果是,干预前的基线还预测不了谁会响应、响应多大;但干预之后,哪些模块变化最大,这个排序在 7 个可评估队列中有 5 个能稳定重现。白话说,把同一队列的人随机分成两半,两边排出来的“变化最大的模块”基本一致[13]。也就是说,现阶段更容易先看清的是“这类干预大致会改变哪些模块”,而不是“这个人会不会响应”。这还不能用来为个人挑选治疗。
熊博士:第三环是“归因”:长寿医学客户常常几项干预一起上。另一篇即将发布的论文审计了,叠加之后的甲基化变化还能不能拆回到每一项头上。初步结论是,能不能拆开,取决于同时用了几项、数据噪声有多大;在模拟测试里,中等噪声下最多三项还能分得开。这只是对数据的审计,还不能证明临床上的归因[14]。
熊博士:最后一环对应 FDA 的上市后追踪:即将发布的长尾药物警戒论文,以司美格鲁肽和 NAION(一种视神经缺血性病变)为例,看罕见不良反应信号能不能被发现和复核,也测试语言模型能看见多少;初步结论是,看得见多少取决于数据[15]。
路径三:地图适配——让不同知识体系都能做贡献
阿康:刚才说到不同知识体系难以兼容,您的办法是什么?
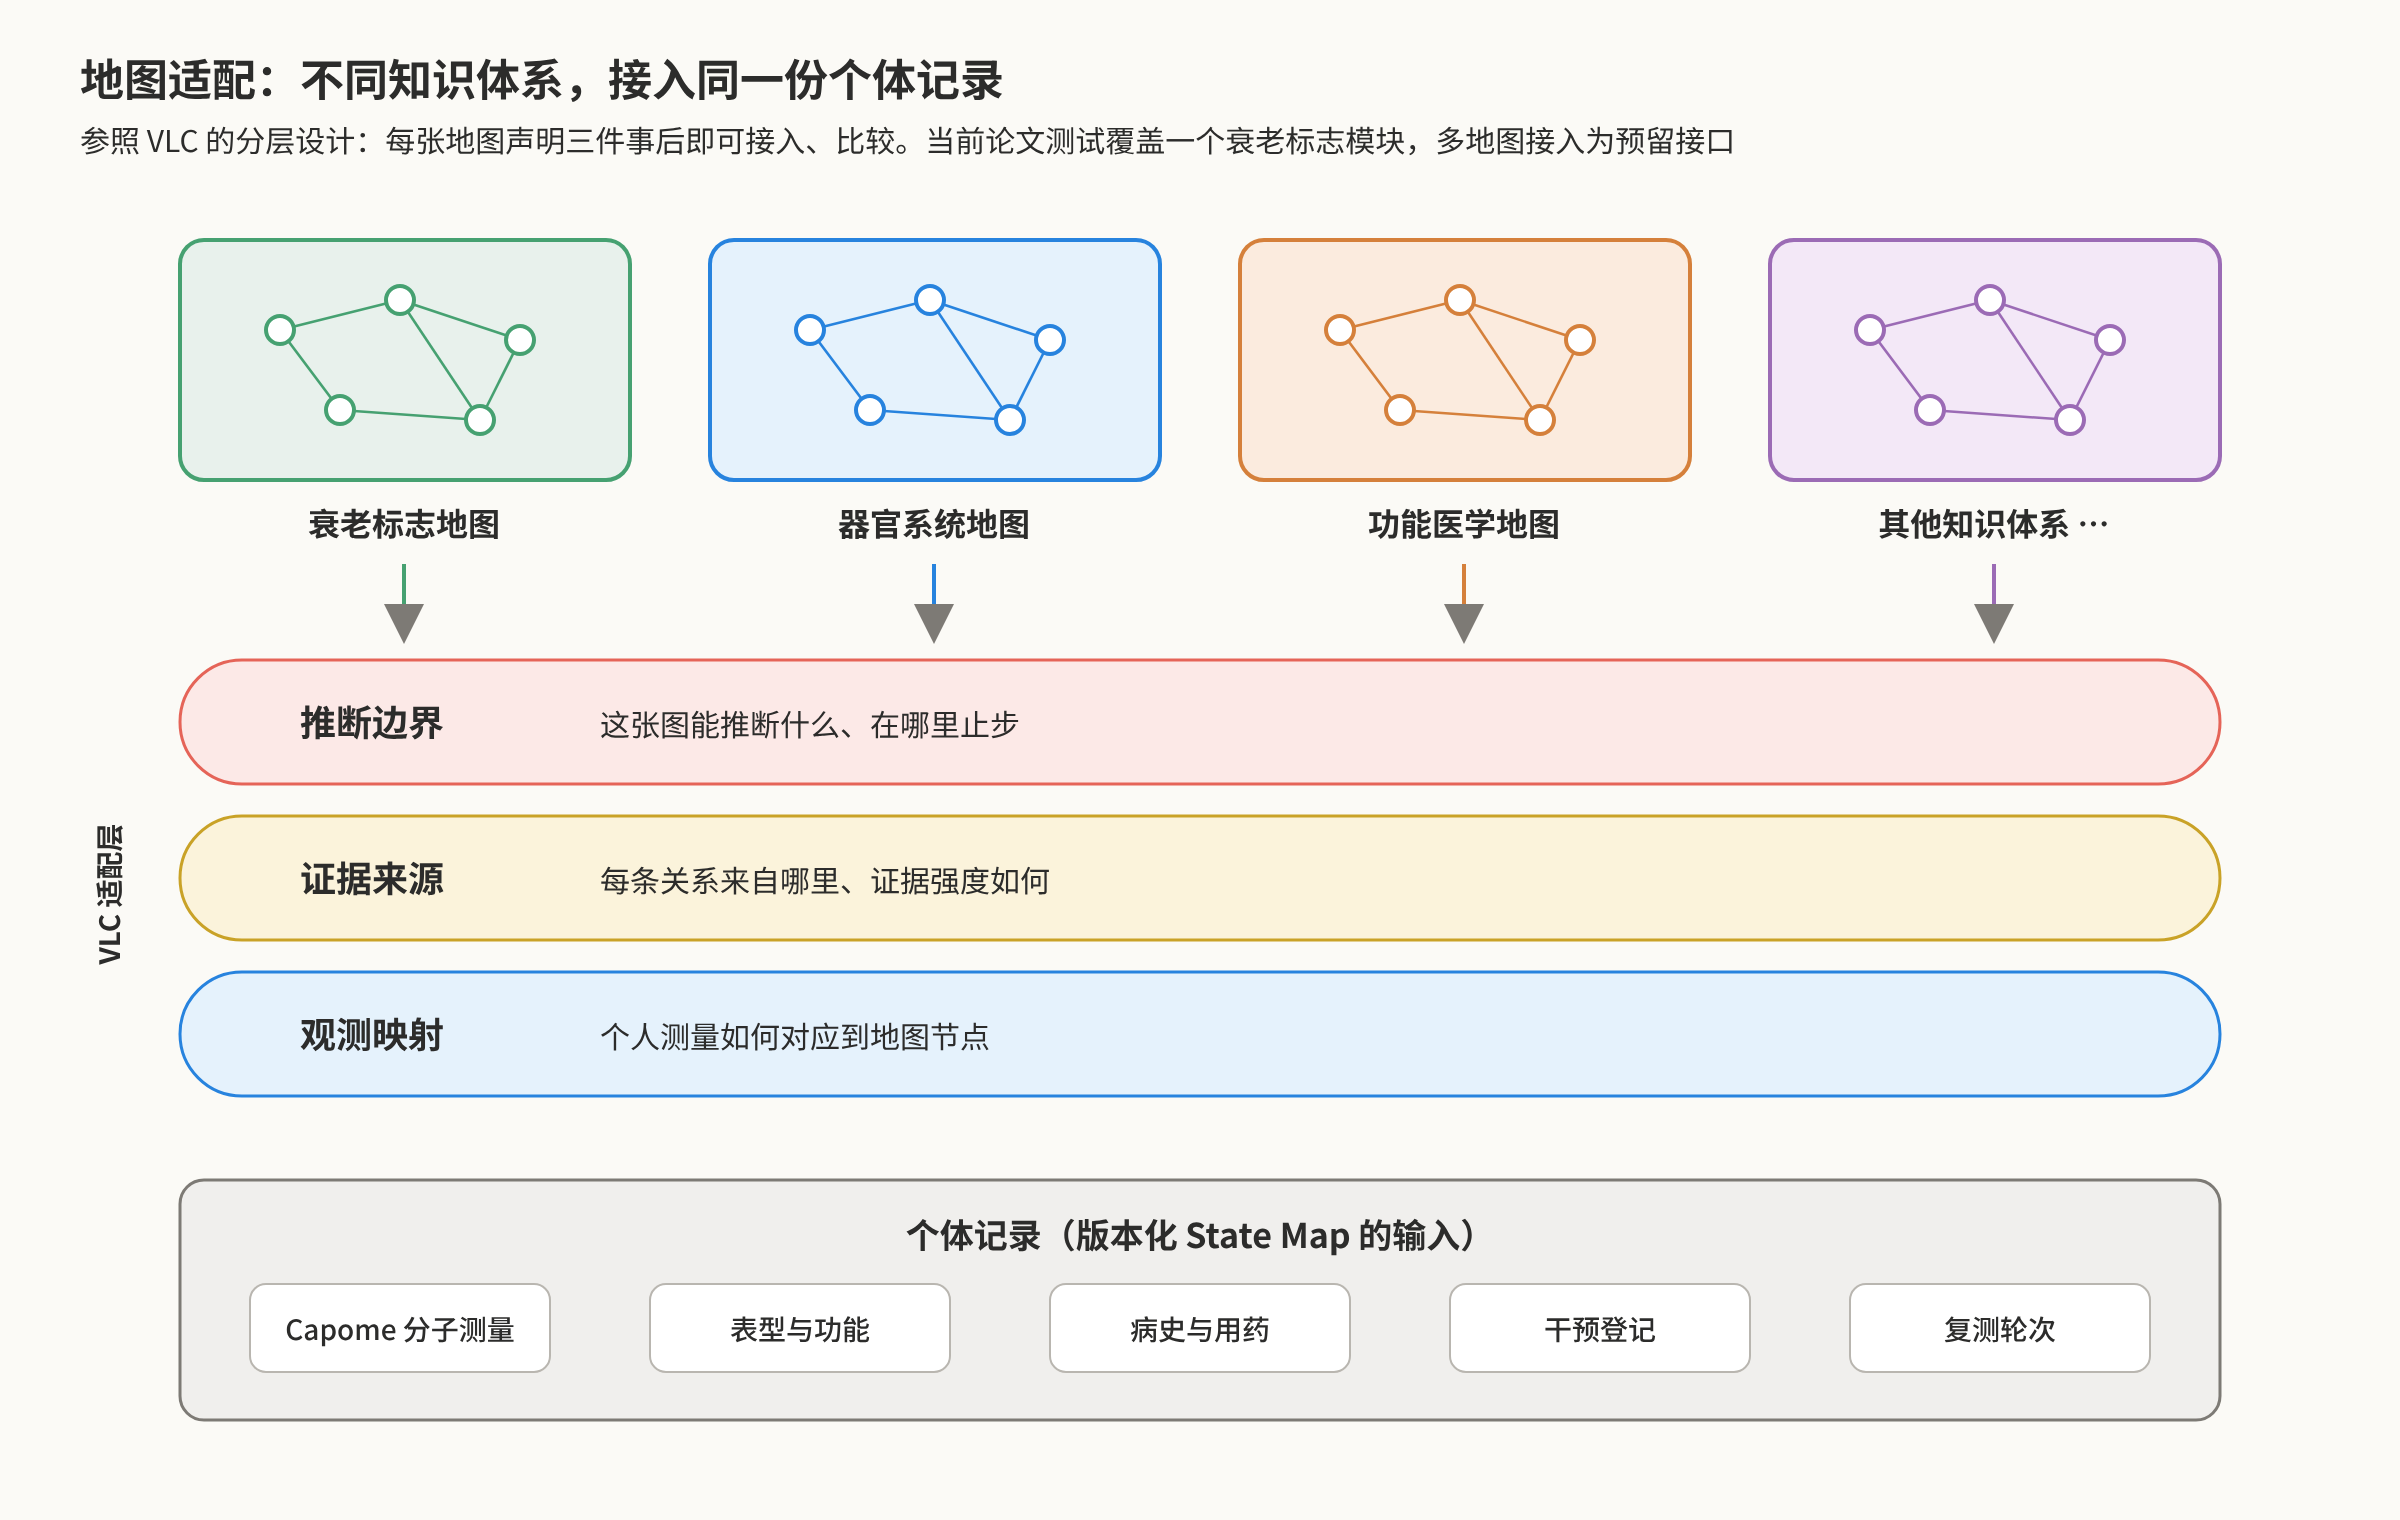
熊博士:不画一张“真理地图”,而是设计“地图的接口”。一张地图要接入,至少要声明三件事:个人测量如何映射到它的节点,它的关系从哪里来,它的推断在哪里止步。VLC 正是把观测映射、证据来源和推断边界分成了独立的层[1]。只要声明清楚,衰老标志、器官系统、功能医学,乃至传统医学的经验,都可以接入同一份个体记录,彼此比较、互相补充。我们的 DNet 依赖网络,就在尝试把中医与现代生物医学放进同一张可计算的模块图里;这是一次结构化接入的探索,不代表两套理论已经等价。
路径四:让地图考试,让经验入账
阿康:8 月发布的 Bench 论文有个结论挺反直觉:不存在普遍最优的生物地图[16]。地图多了,怎么知道哪张好用?
熊博士:让地图考试。用哪张地图,本身就是可测量的研究问题。我们提出从六个维度评价候选地图:压缩、重建、任务效用、迁移、干预闭环支持和可演化性。简单说,就是看它能不能用少量读数讲清一个人,对具体任务有没有用,换一批人是否还成立,能不能接上干预和复测,以及能不能随新证据升级[4]。SteeraMed Bench 公开了一套药物–模块基准,覆盖 332 个模块和 1,916 个小分子药物,就是一个公开的考场。考下来的结果是:不同疾病需要不同的模块组合。
阿康:9 月发布的 GHP 倡议论文,GHP 全称是 Good Healthspan Practice,即“良好健康寿命实践”[17]。一个人的经验,怎样变成大家的知识?
熊博士:要“入账”,而且要有账本规则。GHP 借鉴的是药物研发里的“良好临床实践”(GCP)这类规范的思路,是一套开放、自愿采用的 N-of-1 良好实践框架,目标是让长寿医学里的个人实践,也有一套共同遵守的证据纪律;GPC 是案例档案标准,规定怎么记录。有了账本,就可以转起一个“飞轮”,让知识、数据和产品相互推动。飞轮分三层:科学知识层、实践数据层、产品版本层。层与层之间有四条纪律:反馈不自动等于证据;复测不自动证明因果;接入一张地图不代表它有效;数据积累不等于系统会自动学习。这和 FDA 要求上市后持续收集证据是一个道理。
科学问题,还是工程问题?
阿康:10 月 2 日,马斯克在 X 上发了一条帖子:未来的发现“四舍五入就是 100% 的工程”,因为支配现实的物理规则很少,而用这些规则能做的事情多得多。您怎么看?长寿医学是科学问题,还是工程问题?
熊博士:这个判断很有启发,但放到生命科学里要说得克制一点:生命的基本规律远没有物理学那样清楚,基础发现依然非常重要。传统的生物学研究,往往是一个点的发散:发现一个现象,或者用一种新工具找到一个新分子、一条新通路,再希望推广到更多疾病、更多领域。科学发现都从这里来。但长寿医学实践面对的是一个具体的人:他身上同时有成百上千项读数、好几种慢病、五到十项干预。他需要的不只是再多一个孤立的发现,更需要把已有的发现集成起来、用起来。所以我的做法是:先把工程体系搭起来,再在体系里一个模块一个模块地做研究。科学问题一个都没少,只是每个问题都有了一个可以安放、检验和替换的位置。
熊博士:这套体系的核心是对接和连接:测量要对接到地图,地图要连接到候选干预,干预要连接到复测;不同来源的新知识,要能在同一份个人记录上彼此对话、互相检验。每一轮复测和复盘的结果回流到知识库,经过审核再交还给实践者使用,这就是数据飞轮。前面讲的四大路径,说到底都是在做这件工程。当然,工程不是蛮干:每个接口都要声明证据来源和推断边界,飞轮的每一次转动都要经过审核与验证。
阿康:听下来,您的角色不太像传统意义上的科学家,更像一位架构师。
熊博士:可以这么理解。打个比方,盖一栋楼,有人专门研究砖、钢筋和水泥,这很重要;但总得有人先画好整栋楼的结构:哪里承重,管线怎么走,哪里留接口,将来换一种更好的材料,不必推倒重来。长寿医学现在并不缺好材料,衰老生物学、各类组学、临床医学和传统医学都积累了大量知识,缺的是一张能把它们用到同一个人身上的整体图纸。前面说的三座大山和四条路径,就是这张图纸;已经发布的论文和 DeepKang 上的工程模块,是照着图纸一段一段施工。
熊博士:AI 改变的是架构师的工作方式。过去画好一张图纸,要很多团队写很多年代码,才能知道它行不行;现在 AI 能帮着把一个模块很快搭起来、跑起来、测出来:在 VLC 里,让五个 AI 角色分工讨论一轮,只要两分多钟[1]。架构师就能把精力放在 AI 替代不了的地方:问题怎么拆,接口怎么定,证据规则和推断边界划在哪里。我更愿意把自己看作一个被 AI 赋能的架构师:不追求亲手做出每一块砖,而是让每一块好砖都有地方用、用得对、用完能被检验。
深度甲基在哪里发力
阿康:三座山、四条路径,深度甲基具体在做什么?会排斥别人的路线吗?
熊博士:长寿智能不会只有一条路。虚拟细胞、数字孪生、各类知识图谱和不同医学体系的经验,都可能成为可接入、可比较的地图或模块。我们选择在“个体 × 时间 × 行动”这一段集中发力。
| 位置 | 发力点 | 做法 |
|---|---|---|
| 第一座山:状态表征 | Capome、332 模块 | Capome 提供测量入口;332 个命名模块给出可解释的能力读数[16] |
| 第二座山:地图绘制 | SteeraMed Map(研究预览) | 从个人状态到干预选项的版本化导航,每次修改可回溯;输出的是候选假设,不是因果结论 |
| 第三座山:多病共存 | RootMap、SteeraMed Core、MorbiMap(即将发布) | RootMap 研究衰老标志相关模块与器官衰老模式的状态依赖关系;Core 把个体分子状态与候选干预组织成证据链;MorbiMap 不依赖疾病标签,直接从模块状态给候选干预排序[18][12][8] |
| 路径一:选择智能 | 可驾驭世界模型、VLC State Map | 五个约束检查点与驾驭框架;先研究可预测性,再做预测;状态图版本化、可审计,建议对应回候选选项[9][4][1] |
| 路径二:向 FDA 学 N-of-1 | SteeraMed N-of-1 → VPR → 溯因 → 长尾药物警戒 | 个体推理、确认击中、归因、上市后追踪四环接力;后三篇即将发布[12][13][14][15] |
| 路径三:地图适配 | VLC 分层设计、DNet | 观测映射、证据来源、推断边界分层,为多地图接入留出接口[1] |
| 路径四:地图考试与经验入账 | Bench、GHP、GPC、三层飞轮 | 公开基准;实践纪律;案例记录标准;知识、数据、版本之间的验证关口[16][17] |
走到了哪一站
阿康:现在哪些已经能用,哪些还在路上?
熊博士:研究和产品我们分开讲:VLC 是研究框架和软件测试台,可驾驭世界模型是一条可以被数据检验的研究路线,它们还不是经过临床验证的决策系统;已经交付的是检测、机构工作站和实践规范。各模块成熟度不同,正在一段一段地接起来。
想亲手试试?两个入口
阿康:读者如果想亲手体验,可以去哪里看?
熊博士:两个入口:想看研究的交互式展示,去 SteeraMed.com;想看现在能交付什么,去 DeepKang.com(深度康能)。
熊博士:SteeraMed.com 是我们可驾驭生物医学世界模型的研究门户,各模块配有论文,多数可以在线交互体验:
- Bench 模块基准:332 个模块 × 1,916 个小分子 × 5 个慢病任务(扩展到 23 个疾病类别)。在线 Demo 可以复现论文中的 AI 智能体流程。
- RootMap 条件依赖图谱:看衰老标志模块与器官衰老之间的依赖关系,结论都经过四道统计检查,并在第二个队列中验证方向;这些是血液评分层面的规律,还不是因果证明。交互工具将以研究预览形式开放。
- SteeraMed Map 导航地图:从个人状态到干预选项的版本化导航(v0.1 研究预览),另有面向药企研发的工业工作流 Demo:疾病重分类、患者分层、老药新用、靶点发现。它输出的是候选假设,不是经过因果验证的结论。
- N-of-1 个体化推理:从一个人的分子状态出发,沿四层证据链做干预推理的应用演示,已完成四种疾病的回顾性验证。
- ResponseMap:干预前后配对响应特征的开放图谱,正在征集响应数据。
熊博士:DeepKang.com 的“产品与交付”一栏,每张交付卡都写明了使用对象、输出内容和使用边界:
- 根因博士 2 · 机构工作站(根因医学智能体工具,可演示、可试点):面向功能医学诊所、体检中心、中医机构,支持多组学解读、干预方案制定、干预归因和依从追踪;可在 a.deepkang.com 预约演示,内置九类人群画像的模拟数据演示。它提供 AI 辅助信息参考,不构成诊断与处方,须由执业医师签发。
- Capome 检测 × 解读报告(可购买):甲基化测量、模块状态读出和参考性优化区间;检测报告由合作医学检验机构出具,入口在 deepome.com/capome。
- GHP 良好实践同行(开放共建):面向长寿医学实践者和研究者的 N-of-1 证据工作框架,包括结构化记录、复测轮次、干预登记和归因复盘。
- GPC 根因案例档案标准(开放规范 v1.2):按表型、功能、根因三层做结构化记录。
尾声:一段充满希望的奇妙旅程
阿康:最后,您想对读者说一句什么?
熊博士:长寿智能是一段充满希望的奇妙旅程。智能越来越便宜,真正稀缺的是好问题、好地图和可信的证据。我们不必等整片草原都画完才出发:先找到水草,避开狼和荒漠,沿着一条可检验的路,一站一站往前走。VLC 是新的一站,而路,才刚刚铺开。
参考资料
- Xiong J. The Virtual Longevity Clinic: A Versioned State-Map Framework and Software Testbed for Biomedical World Models. Preprints, 2026. doi:10.20944/preprints202610.0279.v1
- Bunne C, et al. How to build the virtual cell with artificial intelligence: Priorities and opportunities. Cell, 2024, 187(25): 7045–7063.
- De Domenico M, et al. Challenges and opportunities for digital twins in precision medicine from a complex systems perspective. npj Digital Medicine. doi:10.1038/s41746-024-01402-3
- Xiong J. World Models for Biomedicine: Prediction Is the Means, Selection Is the End. Preprints, 2026. doi:10.20944/preprints202609.2101.v1
- Nicholson K, et al. Prevalence of multimorbidity and polypharmacy among adults and older adults: a systematic review. The Lancet Healthy Longevity, 2024, 5(4): e287–e296.
- Chowdhury SR, et al. Global and regional prevalence of multimorbidity in the adult population in community settings: a systematic review and meta-analysis. eClinicalMedicine, 2023, 57: 101860.
- López-Otín C, et al. Hallmarks of aging: An expanding universe. Cell, 2023, 186(2): 243–278.
- Prescribing Without a Disease Diagnosis? Direct Intervention Ranking from a Health State-Representation Map for the Multimorbidity Challenge. 即将发布。
- Xiong J. World Models for Biomedicine: A Steerability Framework. Preprints, 2026. doi:10.20944/preprints202605.0366.v1
- Kim J, et al. Patient-customized oligonucleotide therapy for a rare genetic disease. New England Journal of Medicine, 2019, 381(17): 1644–1652.
- Prasad V, Makary MA. FDA’s New Plausible Mechanism Pathway. New England Journal of Medicine, 2025, 393(23): 2365–2367.
- Xiong J. SteeraMed: A Biomedical World Model for N-of-1 Intervention Reasoning Across Chronic Diseases and Aging. Preprints, 2026. doi:10.20944/preprints202605.1578.v1
- What Can a Biomedical World Model Know about Intervention Response? An Eight-Cohort Virtual-Patient Audit. 即将发布。
- When can multi-intervention effects be disentangled? A decomposability audit of the human methylome's response to interventions. 即将发布。
- Long-Tail Pharmacovigilance: The Semaglutide–NAION Case and a Pilot Benchmark for Language Models. 即将发布。
- Xiong J, Xia Q. Toward a Self-Learning AI Agent for Drug Repurposing: Building Human-Scale Representations for Virtual Patients. Preprints, 2026. doi:10.20944/preprints202608.0998.v2
- Xiong J, Zhang J. When One Person is the Trial: Toward Good Healthspan Practice (GHP), a Draft Good-Practice Guide for N-of-1 Evidence in Longevity Medicine. Preprints, 2026. doi:10.20944/preprints202609.1682.v1
- Xiong J. RootMap: A Longevity Medicine Framework for Mapping Conditional Dependencies Between Aging Hallmarks and Organ-Aging Patterns. Preprints, 2026. doi:10.20944/preprints202609.2376.v1
继续阅读
从虚拟细胞到虚拟病人:中间缺失的那一层
虚拟细胞正当红:Cell 上四十余位学者倡议用多尺度基础模型造一个 AI 虚拟细胞。但病人不是更大的细胞——从细胞到人体隔着多级涌现跃迁,通路代偿与患者异质性让'体外有效'频繁止步于'人体失效'。本文论证:从虚拟细胞到虚拟病人,缺的不是更大的模型,而是另一个尺度的地图——'分子→模块→人体'的换算层;虚拟病人比虚拟细胞多出两样东西:Action 的医学语义(这个人对这个干预有没有响应),以及复测反馈闭环(预测→干预→复测→修正)。最后算一笔经济账:II 期死亡谷、9 亿美元、分层减半——钥匙不在路灯下。
博客数据很多,知识很少:向知识的量化发起进攻
二十多年数据军备竞赛之后,生物医学得到了一个冷峻的判词:数据爆炸,知识贫瘠。知识长期活在三种形态里——游记(文献综述)、标本馆(数据库)、地图(可计算知识),而生物医学最缺的正是第三种。本文从科学史角度论证:一门学科的成熟,标志是其核心知识从叙事变成可运算的对象;天文学有星表,化学有元素周期表,生物医学还没有自己的知识坐标系。是时候向知识的量化发起进攻了:参数化、结构化、闭环化——让世界观第一次拥有可计算的载体。
博客什么是世界模型?为什么它不只是一个预测模型
预测模型回答会怎样,世界模型回答如果这样做会怎样。医学AI不能只会预测,还要学会推演行动后果。世界模型的核心结构是五个要素:State(当前状态)、Action(可选动作)、Transition(状态转移)、Objective(目标方向)、Feedback(反馈校准)。未来医学AI的核心竞争,不只是模型更大、数据更多、预测更准,而是谁能把生命系统表示为可解释、可推演、可反馈、可校准的世界模型。